PLUS
生成AIコラム
うさぎでもわかるGemini Omni 1.1 Flash
はじめに
こんにちは、2026年8月27日にGoogleが動画生成・編集モデル「Gemini Omni 1.1 Flash」を発表しました。前回は無印のGemini Omni Flashをマルチモーダル全般にフォーカスして紹介しましたが、今回は1.1で強化された動画生成機能に絞って深掘りしていきます。
先に要点をまとめておきます。
- シーン拡張が直前10秒分の文脈を見るようになり、キャラクターや照明の一貫性を保ったまま最大40秒まで延長可能に
- 開始フレームと終了フレームを指定するだけでカメラワークを作れる新機能が追加
- 既存動画をリファレンスにしてキャラクターや動きのパターンを継承できるように
- 360pドラフトから4Kまで解像度を使い分けてコストを最適化できる
これから動画生成AIを業務やプロダクトに組み込もうとしているエンジニアの方の判断材料になればうれしいです。
生成AIの社内利用をお考えの企業様へ
ナレフルチャットは初心者でも使いやすい設計で、組織全体への生成AI浸透を支援するツールです。プロンプト自動生成機能や社内共有機能により、AIリテラシーに差があっても全員が活用できます。企業のAI導入を検討している方は、こちらをご覧ください。
Gemini Omni 1.1 Flashとはなにか
前回紹介した無印のGemini Omni Flashは「あらゆる入力からあらゆるメディアを生成する」ことを掲げる世界モデルとして注目を集めました。今回のOmni 1.1 Flashは、その中でも動画生成と編集の精度を大きく引き上げるアップデートという位置づけです。
すでにAdobe Firefly、Figma Weave、GMI Cloud、Runwayといった制作ツール各社が導入しており、Googleは「映像制作の現場で使える水準」になったとアピールしています。
ポイントを箇条書きで押さえておきます。
- 発表 2026年8月27日
- モデルID
gemini-omni-1.1-flash - 位置づけ Gemini Omni Flash(無印)の動画生成・編集アップデート版
- 導入企業 Adobe Firefly、Figma Weave、GMI Cloud、Runwayなど
- 提供チャネル Google AI Studio、Gemini API、Gemini Enterprise Agent Platform、Google Flow、Geminiアプリ
前回記事で紹介した無印Omniは、任意の入力を束ねて音声付き動画を生成するコンセプトモデルという色合いが強いものでした。1.1では、開発者が本番運用で使うための「制御性」が大きく強化されています。コンセプト実証から実務ツールへ育ってきた印象うさよ🐰
動画生成の進化ポイント
Omni 1.1 Flashで動画生成にまつわる新機能は大きく4つあります。どれも「AIに動画を作ってもらうときの、地味だけど困っていた部分」を解消する機能です。それぞれ何がうれしいのかを噛み砕いて紹介します。
シーン拡張 動画の続きをどこまで覚えて作ってくれるか
動画生成AIで10秒のクリップを作っても、それだけではストーリーとして物足りないことがよくあります。シーン拡張は、すでにできあがった動画の続きをAIに作ってもらう機能です。
ここで重要なのが「AIが直前のどこまでの場面を覚えていてくれるか」という記憶の範囲です。無印Omniでは直前1秒分しか参照できず、一貫性を保ったまま延長するのが難しいという課題がありました。1.1では直前10秒分をまるごと参照できるようになり、10秒ずつ、最大40秒まで積み上げられるようになっています。
もし延長を繰り返しても違和感が出るようなら、拡張のたびに服装や小道具、照明といった保ちたい要素をプロンプトで毎回書き添えておくと一貫性を保ちやすくなるとうさ。末尾への追記のみに対応しており、動画の先頭に足したり途中に挿入したりすることはできない点は覚えておいてください。
開始/終了フレーム制御 最初と最後の写真だけで間の動きを埋めてくれる
動画の途中の動きを言葉だけで細かく指示するのは、意外と大変な作業です。この機能は、始まりの状態と終わりの状態を写真2枚で渡すだけで、その間をどうつなぐかをAIが考えてくれるというものです。
たとえば「商品が置かれた状態」の写真と「誰かが手に取った瞬間」の写真を渡すと、その間のカメラワークやズームをモデルが自動で埋めてくれます。同じ写真を最初と最後の両方に指定すれば、途切れのないシームレスループ動画を作ることもできます。
動画リファレンス お手本の動きを新しいシーンでも再現してくれる
「この抜刀の動作、気に入ったからほかのシーンでも使いたい」というときに便利な機能です。お手本にしたい動画を最大3秒×3本までAIに見せると、その動きやキャラクターの雰囲気を新しいシーンに引き継がせることができます。ただし、複数のお手本動画同士を比較したり関連づけて推論したりすることはできず、あくまでそれぞれ独立した参考素材として扱われる点は注意してください。
解像度オプション 試作と本番で画質とコストを使い分けられる
動画は一発でOKになるとは限らず、何パターンも試して方向性を決めたいことがよくあります。1.1では360pという粗い画質のドラフトモードが追加され、720p比で最大60%速く、コストも3分の1で試作できるようになりました。方向性が決まったら720p以上で本番出力する、という使い分けが現実的になっています。1080pと4Kは元の映像を引き伸ばすアップスケール扱いで、最初から高精細に生成しているわけではない点は押さえておきたいところです。
解像度以外にも、アスペクト比は横向きの16:9(デフォルト)と縦向きの9:16から選べます。SNS用のショート動画を作りたいときは縦向き指定が便利です。
料金と制約事項まとめ
料金体系
解像度別の秒単価は以下の通りです。
| 解像度 | 価格/秒 |
|---|---|
| 360p | $0.03 |
| 720p | $0.10 |
| 1080p | $0.15 |
| 4K | $0.30 |
入力側のコストはテキスト・画像・動画・音声まとめて100万トークンあたり$1.50です。Geminiアプリ(Google AI Plus / Pro / Ultra)加入者はシーン拡張機能を追加課金なしで利用できます。
制約事項
実際に使う前に知っておきたい制約もまとめておきます。似た機能があるからと期待しすぎると肩透かしになる部分なので、先に押さえておくと安心です。
- シーン拡張は末尾への追記のみ対応(先頭挿入・途中挿入は非対応)
- 既存動画をアップロードしてシーン拡張する場合、元動画は10秒以内である必要があります
- 複数の動画リファレンス同士を比較したり関連づけて推論したりすることはサポートされていません
- 英語はフルサポートですが、他言語での挙動は未評価とされています
- 生成された動画にはSynthIDウォーターマークが自動で埋め込まれ、無効化はできません
法人向け生成AIサービス「ナレフルチャット」では、ChatGPT、Gemini、Claudeなど主要プロバイダのAIモデルを選んで利用可能!用途に応じて、料金の低いモデルを使うなど最適なAI活用を可能にします。
また、料金プランは企業単位の定額制を採用しており、何人で利用しても追加のコストは発生しないため、コスト管理の手間がかからないスムーズな全社導入を実現できます。
すべての機能が利用できるトライアル期間も用意しておりますので、生成AIの利活用を検討している企業様は、是非一度導入をご検討ください。実際に動画を生成してみた
今回はOmni 1.1最大の目玉であるシーン拡張に絞って検証しました。開始/終了フレーム制御や動画リファレンスも新機能ではありますが、似た仕組みのカメラワーク指定や参照素材の機能自体はVeoの時代から存在するため、本記事では見送っています。
検証環境
- 利用チャネル Google Flow
- 利用モデル Gemini Omni 1.1 Flash
検証パターン シーン拡張
社会人の1日ルーティン(朝の身支度 → 通勤 → オフィス)というシーンが大きく切り替わるストーリーで、顔立ちや服装が崩れずに引き継がれるかを検証しました。使用したプロンプトは以下の通りです。
初回生成 朝 身支度
0-2秒 マンションの一室、朝の光が差し込む洗面所。20代後半の日本人
男性会社員が鏡の前に立っている。黒髪の短髪、丸メガネ、寝起きの
やや眠そうな表情。顔のアップから始まる。
2-4秒 男性が水で顔を洗い、タオルで拭く。鏡越しに自分の顔を
まっすぐ見つめ、軽く頬を叩いて気合いを入れる。顔のクローズアップ
を維持。
4-7秒 寝室に移動し、ハンガーにかけた紺色のスーツと水色の
ワイシャツに着替える。ワイシャツのボタンを上から順に留めていく
手元のアップ。
7-10秒 姿見の前でネクタイを締め、シルバーの腕時計を左手首に
つける。全身を映す鏡の前でスーツ姿を確認し、軽くうなずく。
シネマティック、朝の柔らかい自然光。
シーン拡張1 通勤
0-2秒 玄関で革靴を履き、鞄を持って家を出る男性。ドアを閉める瞬間、
振り返って一瞬だけ顔がアップになる。丸メガネと紺色のスーツは
そのまま。
2-5秒 駅までの道を歩く後ろ姿から、追い越しざまに横顔のアップへ
切り替わる。水色のワイシャツの襟元と腕時計が見える構図。
5-8秒 駅のホームで電車を待つ。スマートフォンを確認する手元と、
画面を見る真剣な表情の顔のアップ。
8-10秒 満員電車のドア付近に立つ男性。窓に反射した自分の顔を
一瞬見て、軽くメガネの位置を直す仕草。
シネマティック、通勤ラッシュの雑踏音。
シーン拡張2 オフィス
0-2秒 オフィスのデスクに座る男性。紺色のスーツの上着は椅子に
かけ、水色のワイシャツ姿でパソコンに向かっている。正面から顔の
アップ。
2-5秒 会議室に移動し、同僚数名と向かい合って着席する。資料を
指差しながら話す男性の表情のアップと、腕時計をちらっと確認する
仕草。
5-8秒 会議室のホワイトボード前に立ち、身振りを交えて説明する。
胸元の水色のワイシャツと紺色のスーツのズボンが見える全身ショット。
8-10秒 デスクに戻り、疲れた表情で椅子にもたれる。丸メガネを
外して目元を軽くもみ、また掛け直す顔のクローズアップ。
シネマティック、オフィスの環境音。
顔まわりの一貫性比較
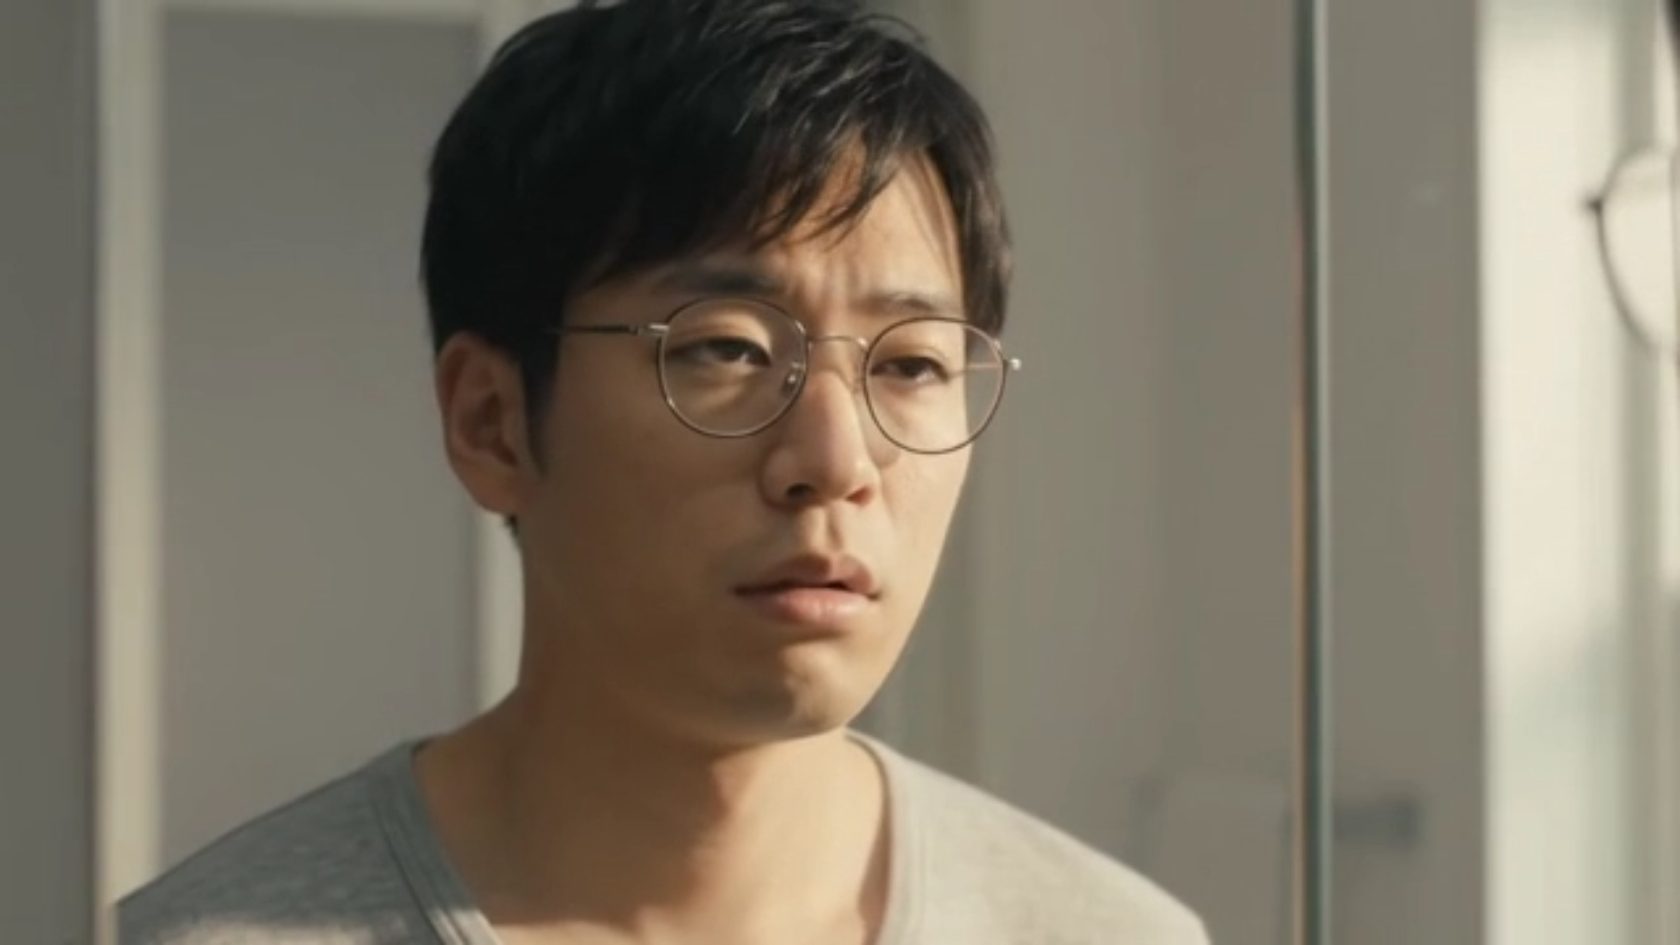
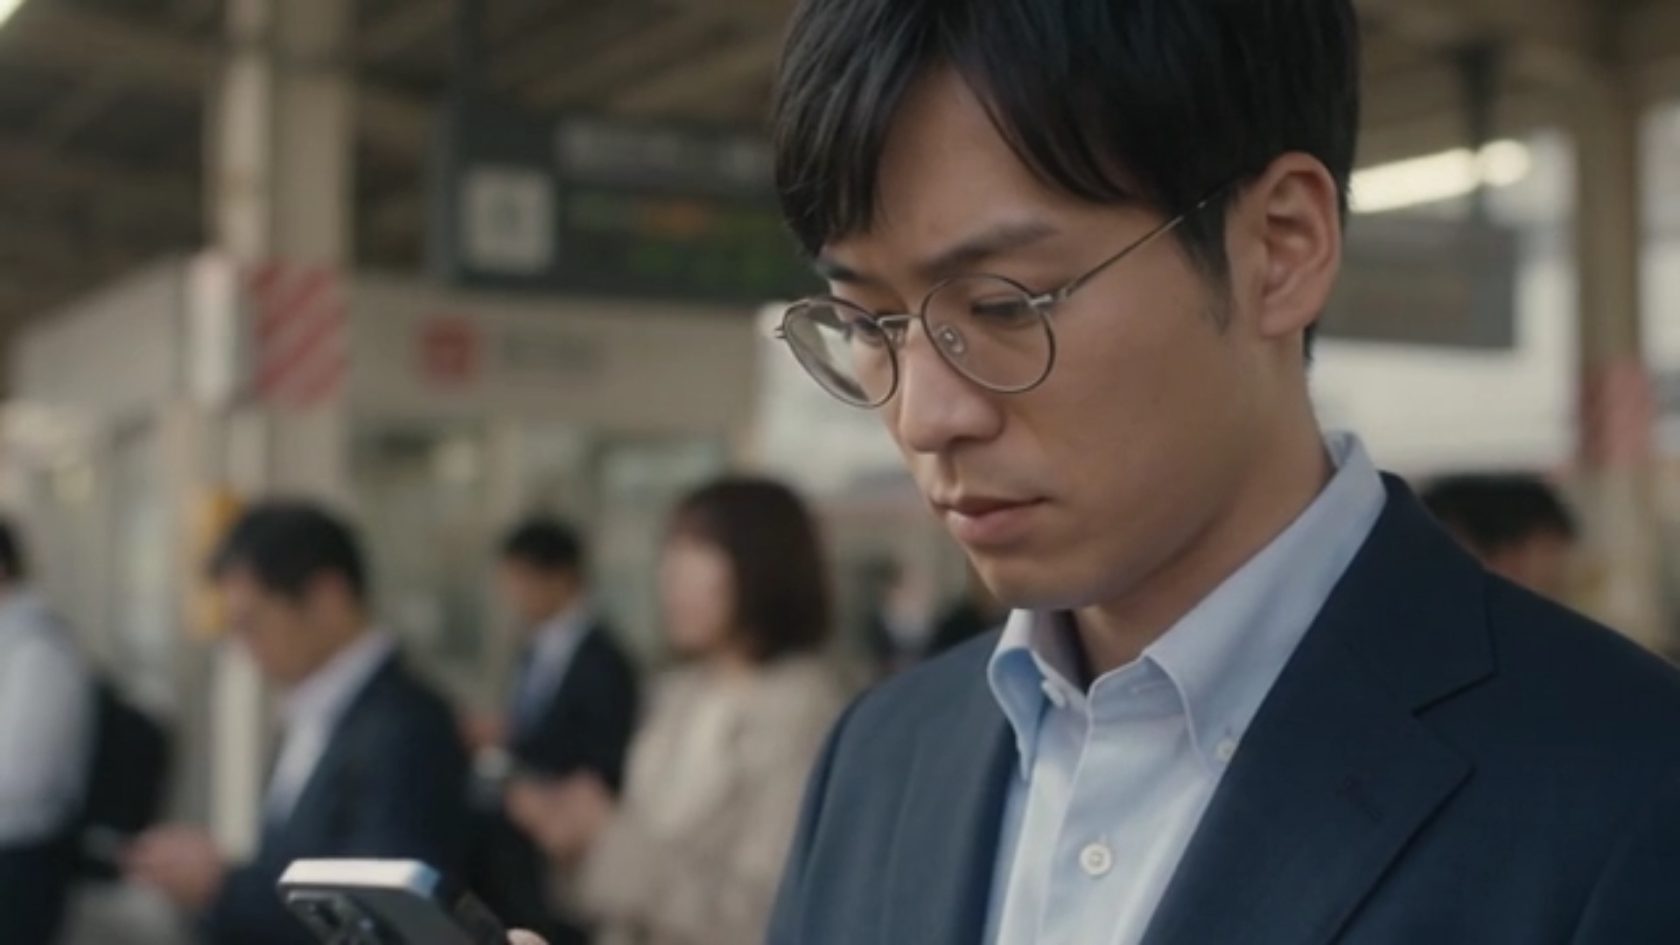
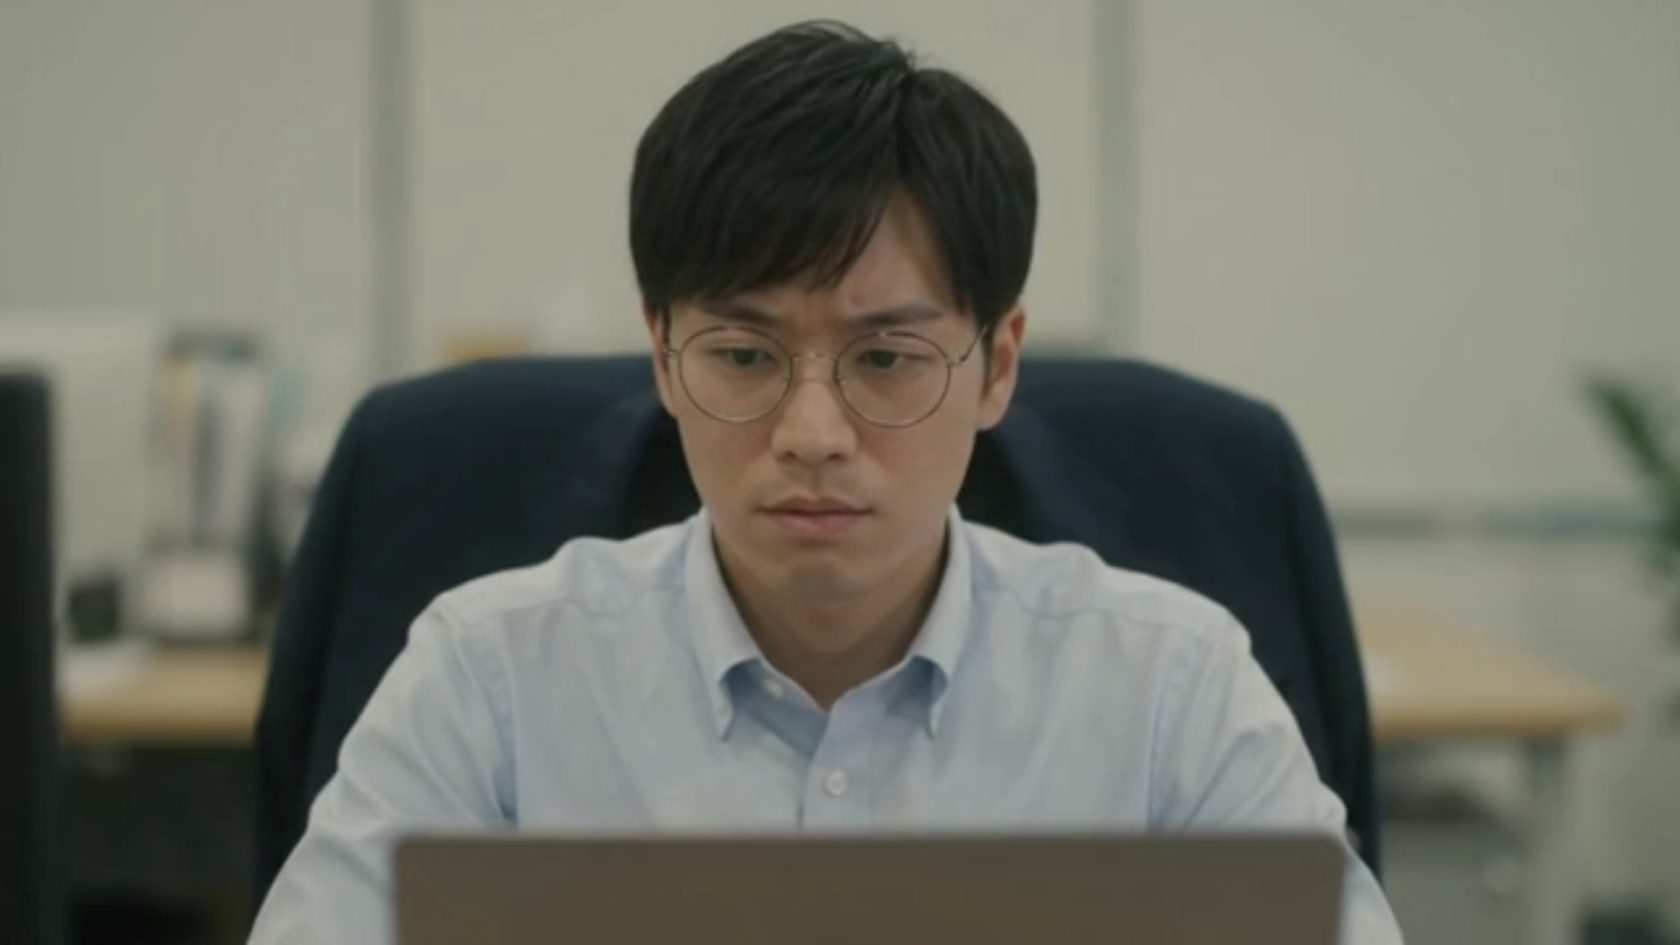
3つのシーンから顔のアップカットを1枚ずつ切り出して並べました。
初回生成 朝の身支度
シーン拡張1 通勤
シーン拡張2 オフィス
考察
3シーンを並べてみると、丸メガネの形状、黒髪の分け方、輪郭や目元の特徴は一貫して同一人物として通用するレベルで保たれていました。無印Omniは直前1秒しか参照できない仕様だったため理屈の上では起きやすいはずの「拡張のたびに顔立ちが少しずつ変わっていく」ような崩れは見られません。
服装も、初回の部屋着から通勤・オフィスでの紺色のスーツ+水色のワイシャツへと、プロンプト通りの流れで自然に変化しています。強いて挙げるなら、メガネのフレームの太さやブリッジの形が、朝のシーンとそれ以降のシーンで微妙に異なって見える点は気になりました。極端な違和感ではありませんが、10秒刻みでの拡張を重ねるほど、こうした細部の揺らぎは蓄積しやすいポイントだと感じます。
検証総括
シーン拡張だけに絞った検証でしたが、「シーンが大きく切り替わっても人物の同一性を保てるか」という一番気になっていたポイントは、実用に足るレベルでクリアしていました。直前1秒しか参照できなかった無印の仕様を踏まえると、直前10秒参照への進化は数字以上に効いている印象を持ったうさよ🐰
一方で、メガネのフレームのような細部は完璧に固定されるわけではないため、商用利用でキャラクターの厳密な同一性が求められる場面では、生成後に細部だけ手直しする前提で使うのが現実的だと感じました。
まとめ
Gemini Omni 1.1 Flashは、無印Omniのコンセプトを土台にしながら、動画生成と編集の制御性を大きく引き上げたアップデートです。ポイントを最後にもう一度整理しておきます。
- シーン拡張が直前10秒分の文脈を見るようになり、最大40秒まで一貫性を保って延長可能
- 開始/終了フレーム制御でカメラワークを狙って作れるようになった
- 動画リファレンスでキャラクターや動きのパターンを継承できる
- 360pドラフトから4Kまで解像度を使い分けてコストを最適化できる
制作現場での本格運用が視野に入ってきたモデルなので、まずはGoogle FlowやGoogle AI Studioで小さく試してみるのがおすすめうさよ🐰
あなたも生成AIの活用、始めてみませんか?
生成AIを使った業務効率化を、今すぐ始めるなら
「ユーザ数無制限」の法人向け生成AIサービスのナレフルチャット!
ChatGPT・Gemini・Claudeなどの主要AIモデルが使えて、
RAGやAIエージェント、スライド生成など全てナレフルチャットにお任せ!
生成AIの利用方法を学べる「公式動画」や、「プロンプトの自動生成機能」を
使えば知識ゼロの状態からでも、スムーズに生成AIの活用を始められます。
taku_sid
https://x.com/taku_sid
AIエージェントマネジメント事務所「r488it」を創立し、うさぎエージェントをはじめとする新世代のタレントマネジメント事業を展開。AI技術とクリエイティブ表現の新たな可能性を探求しながら、次世代のエンターテインメント産業の構築に取り組んでいます。
ブログでは一つのテーマから多角的な視点を展開し、読者に新しい発見と気づきを提供するアプローチで、テックブログやコンテンツ制作に取り組んでいます。「知りたい」という人間の本能的な衝動を大切にし、技術の進歩を身近で親しみやすいものとして伝えることをミッションとしています。

スマートフォンでもAI活用!
アプリ版「ナレフルチャット」配信中
iPhoneはこちら
Androidはこちら